
Penulis: Prof. Madya Dr. Nurulkamal Masseran
Pensyarah Kanan
Jabatan Sains Matematik, Universiti Kebangsaan Malaysia
Dunia di sekeliling kita sentiasa saling berkait. Penyataan ini membawa maksud bahawa sebarang perubahan dalam satu aspek kehidupan seringkali akan mempengaruhi aspek yang lain. Antara contohnya, apabila pendapatan isi rumah meningkat ianya boleh mempengaruhi perubahan harga barangan. Apabila amaun hujan bertambah, paras air sungai akan meningkat. Apabila kadar faedah berubah, pelaburan asing dalam pelbagai sektor akan terkesan. Apabila satu polisi berubah, tingkah-laku masyarakat juga boleh berubah. Senario-senario seperti ini jelas menggambarkan bagaimana suatu peristiwa akan saling mempengaruhi peristiwa yang lain. Oleh itu, adalah penting untuk kita memahami tingkah-laku hubungan-hubungan sebegini terutama untuk tujuan perancangan dan pembuatan keputusan.
Ukuran korelasi merupakan satu penunjuk yang sering dijadikan rujukan dalam menilai hubungan dalam data. Korelasi merujuk kepada teknik statistik yang mengukur sejauh mana dua atau lebih pemboleh ubah bergerak secara bersama. Secara umumnya, korelasi menjawab persoalan, “apabila nilai pemboleh ubah X berubah, adakah pemboleh ubah Y akan cenderung untuk berubah juga?” (Chattamvelli, 2024). Sebagai contoh, misalkan kita ingin menguji senario “jika tahap pendidikan meningkat, adakah tahap pendapatan juga akan meningkat?”. Bagi menilai kekuatan hubungan ini, jika nilai korelasi yang diukur hampir kepada +1, ianya menggambarkan hubungan positif yang kuat, yang membawa tafsiran bahawa, tahap pendidikan tinggi mempunyai perkaitan rapat dengan tahap pendapatan tinggi. Sebaliknya, jika didapati nilai korelasi hampir kepada -1, ianya menggambarkan hubungan negatif yang kuat, dengan tafsiran, tahap pendidikan tinggi, namun pendapatan adalah rendah. Manakala, jika nilai korelasi yang hampir kepada 0, ianya menunjukkan hubungan yang lemah atau tiada hubungan, dengan tafsiran, tiada trend yang ketara antara tahap pendidikan dengan tahap pendapatan. Namun, hubungan antara data mempunyai pelbagai variasi. Maka, tiada satu teknik korelasi yang khusus yang boleh digunakan secara sembarangan tanpa pertimbangan yang baik terhadap sifat data. Dalam artikel ini, kita akan membincangkan kepelbagaian teknik ukuran korelasi dan bagaimana untuk memilih teknik yang sesuai dengan ciri-ciri data yang khusus. Namun perlu diingatkan di sini bahawa hubungan korelasi bukanlah hubungan sebab-musabab (causality) antara dua peristiwa.
Korelasi Pearson, Spearman dan Kendall-tau
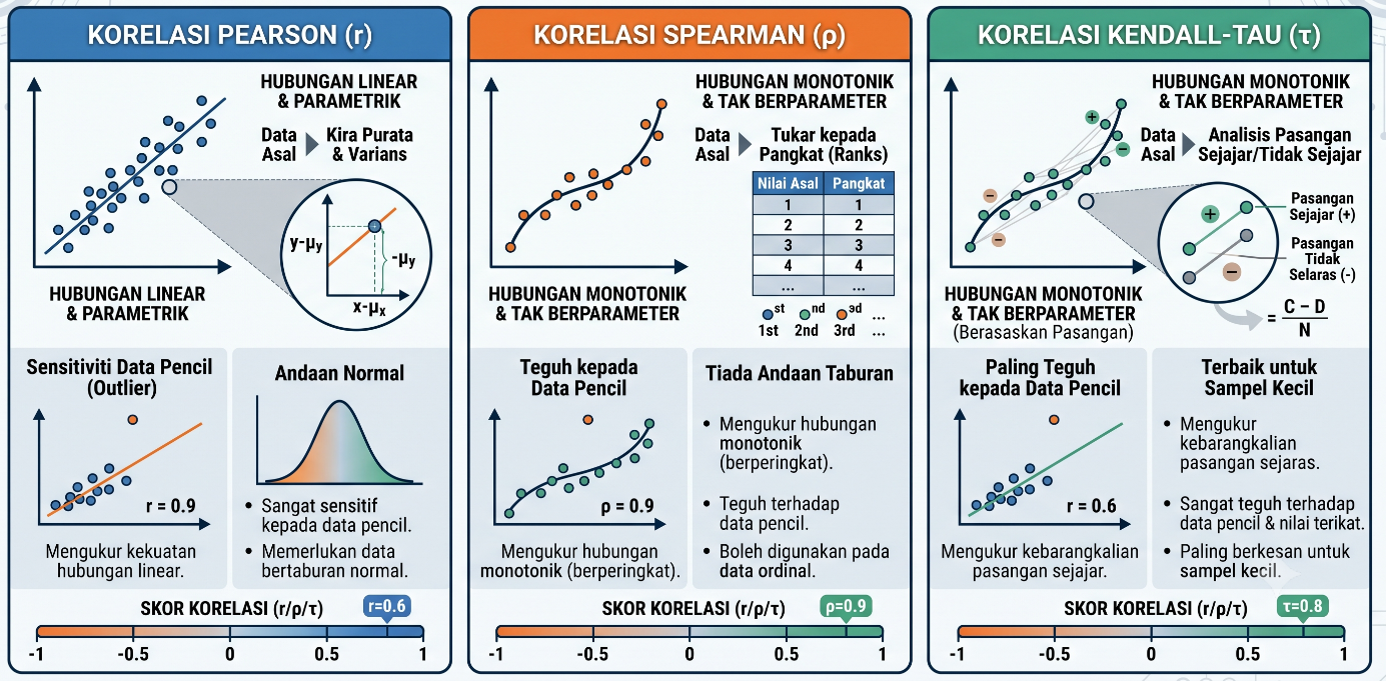
Asas korelasi mula dikaji oleh tokoh ilmuan British iaitu Francis Galton pada sekitar abad ke-19. Beliau pada asalnya menyelidiki hubungan antara ciri-ciri biologi dan sifat fizikal manusia, yang seterusnya membawa kepada konsep hubungan bersama (co-relation) antara dua pemboleh ubah yang menjadi asas teknik korelasi dan regresi (Galton,1988). Seterusnya, ahli statistik British iaitu Karl Pearson memperkenalkan ukuran matematik bagi hubungan linear yang kini kita dikenali sebagai korelasi Pearson (Pearson, 1896). Korelasi Pearson merupakan ukuran statistik yang paling kerap digunakan dalam pelbagai bidang. Ianya mengukur hubungan linear antara dua pemboleh ubah yang selanjar. Namun, ramai tidak mengetahui bahawa untuk menggunakan teknik korelasi Pearson, data perlulah bertaburan Normal. Malah, teknik korelasi Pearson juga sangat sensitif terhadap kewujudan data-data pencil.
Bagi mengatasi kekurangan kaedah korelasi Pearson, korelasi Spearman adalah kaedah tak berparameter yang mengukur korelasi menerusi konsep hubungan ekanada (monotonic). Hubungan ekanada bermaksud apabila satu pemboleh ubah meningkat/menurun, pemboleh ubah yang satu lagi juga meningkat/menurun, tetapi tidak semestinya pada kadar yang tetap. Kaedah ini sesuai bagi data jenis ordinal atau data selanjar yang tidak bertaburan Normal menerusi penjelmaan nilai data sebenar kepada nilai pangkat (Zar, 2005). Kaedah ini lebih teguh terhadap kewujudan data pencil. Selain daripada korelasi Spearman, kaedah korelasi Kendall-tau juga merupakan kaedah alternatif yang mengukur hubungan ekanada menggunakan susunan pangkat data. Namun ianya menggunakan konsep pasangan sejajar (concordant pairs) dan pasangan tak sejajar (discordant pairs) yang membandingkan setiap pasangan titik data untuk melihat sama ada susunan data X sepadan dengan susunan data Y (Kendall,1948). Korelasi Kendall-tau adalah lebih sesuai digunakan berbanding korelasi Spearman bagi kes saiz sampel yang kecil ataupun bagi kes data dengan banyak pangkat yang terikat (tied ranks).
Nota: Imej ini dijana menggunakan Google Gemini
Korelasi Tetrakorik dan Polikorik
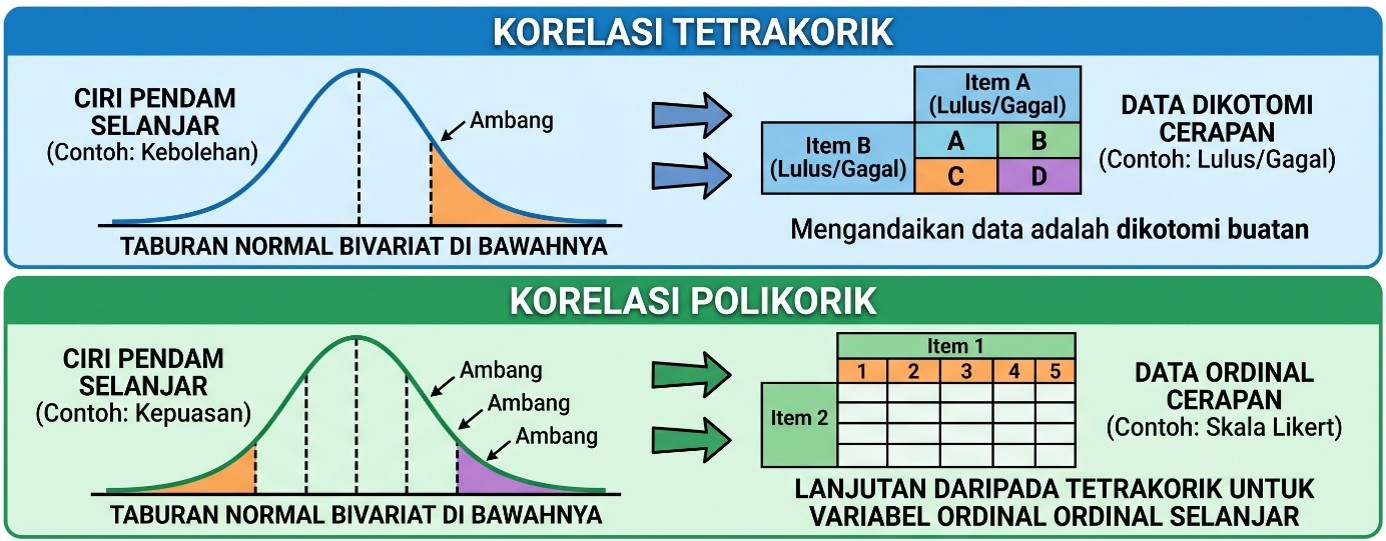
Korelasi tetrakorik dan korelasi polikorik merupakan ukuran korelasi terhadap data jenis berkategori dengan andaian bahawa kategori-kategori tersebut sebenarnya terbit daripada pemboleh ubah pendam selanjar yang bertaburan normal. Secara khususnya, korelasi tetrakorik berguna untuk mengukur hubungan antara dua pemboleh ubah dikotomi (dichotomy). Di sini, pemboleh ubah dikotomi merujuk kepada jenis data berkategori yang mengambil nilai dedua seperti nilai “Ya atau Tidak”, “Lulus atau Gagal”, “Tinggi atau Rendah”, “Berisiko atau Tidak”, dan lain-lain. Sebagai contoh, kita berminat untuk mengkaji hubungan korelasi antara status “Lulus atau Gagal” bagi ujian Matematik dengan status “Lulus atau Gagal” bagi ujian Sains di sebuah negeri. Pada asalnya, data markah pelajar adalah data berangka yang selanjar dalam julat 1-100 markah dan menghampiri bertaburan normal. Ianya dijelmakan kepada status “Lulus atau Gagal” berdasarkan satu titik markah ambang (threshold mark). Korelasi tetrakorik memboleh hubungan kebolehan sebenar status pelajar tersebut diukur dengan lebih tepat.
Manakala, korelasi polikorik merupakan pengitlakan terhadap konsep korelasi tetrakorik yang boleh digunakan untuk mengukur hubungan antara dua pemboleh ubah ordinal yang mempunyai lebih daripada dua kategori. Di sini, data jenis ordinal merujuk kepada berkategori yang mempunyai sifat bertertib seperti skala Likert (1-5), tahap pendapatan (Rendah, Sederhana, dan Tinggi), tahap risiko (Baik, Risiko Rendah, Amaran, dan Berbahaya). Sebagai contoh, misalkan anda menganalisis data kaji selidik untuk melihat hubungan antara tahap tekanan dan tahap kelesuan dikalangan pekerja dengan skala Likert yang mengambil nilai “Sangat Tidak Setuju (1)” hingga “Sangat Setuju (5)”. Dalam data sebegini, walaupun responden memilih jawapan dari skala 1 hingga 5, namun sebenarnya perasaan tertekan dan rasa kelesuan manusia adalah berada dalam satu spektrum yang selanjar. Korelasi polikorik merupakan ukuran yang sesuai untuk menilai hubungan data sebegini.
Nota: Imej ini dijana menggunakan Google Gemini
Korelasi Dwi-Siri dan Polisiri
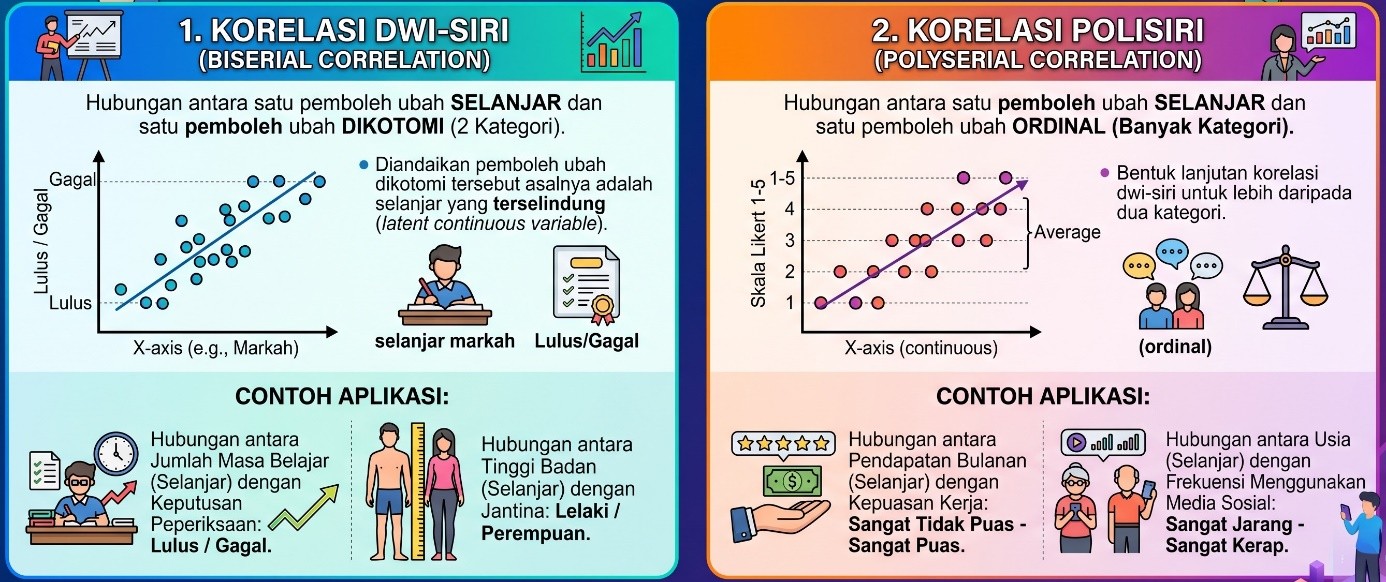
Korelasi dwi-siri dan korelasi polisiri pula merupakan kaedah ukuran korelasi bagi menilai hubungan antara pasangan pemboleh ubah selanjar dengan pemboleh ubah berkategori (Drasgow, 1986). Secara khususnya, korelasi dwi-siri perlu digunakan jika kita berhadapan dengan data pemboleh ubah selanjar dengan data pemboleh ubah dikotomi. Sebagai contoh, data bagi hubungan antara jumlah jam ulang kaji seminggu (data selanjar) dengan keputusan ujian kelayakan yang dikategorikan sebagai Lulus atau Gagal (data dikotomi). Manakala, korelasi polisiri merupakan pengitlakan terhadap konsep korelasi dwi-siri yang mengukur hubungan antara pasangan pemboleh ubah selanjar dengan pemboleh ubah ordinal yang mempunyai lebih daripada tiga. Sebagai contoh, data bagi hubungan antara pendapatan bulanan sebenar dalam Ringgit Malaysia (data selanjar) dengan tahap kebahagiaan yang diukur menggunakan skala Likert 1 hingga 5 (data ordinal).
Nota: Imej ini dijana menggunakan Google Gemini
Korelasi Separa dan Semi-Separa
Teknik korelasi separa dan korelasi semi-separa pula perlu digunakan apabila kita berurusan dengan tiga atau lebih pemboleh ubah secara serentak. Peranan korelasi jenis ini adalah untuk membolehkan kita memahami hubungan yang tulen antara dua pasangan pemboleh ubah dengan mengawal kesan pemboleh ubah ketiga (Wang, 2013). Sebagai contoh, jika kita menggunakan kaedah korelasi lain dan kita mendapati terdapat korelasi positif yang tinggi antara tahap pendapatan dengan kesihatan. Namun, ini tidak semestinya kita boleh simpulkan bahawa individu yang mempunyai tahap pendapatan yang lebih tinggi akan mempunyai tahap kesihatan yang baik. Wujud kemungkinan ada faktor ketiga yang mempengaruhi hubungan tersebut seperti faktor gaya hidup. Oleh itu, penggunaan korelasi separa adalah penting untuk mengawal kesan faktor gaya hidup bagi tujuan untuk mendapat ukuran yang lebih tepat terhadap hubungan sebenar antara tahap pendapatan dengan tahap kesihatan.
Manakala, korelasi semi-separa perlu digunakan jika kita ingin mengukur hubungan antara pasangan dua pemboleh ubah (X1 dan X2), dengan kesan pemboleh ubah ketiga (X3) hanya dibuang daripada salah satu pemboleh ubah (X1 atau X2). Teknik ini penting untuk menilai magnitud sumbangan unik sesuatu pemboleh ubah tak bersandar (X1) terhadap pemboleh ubah bersandar (X2), tanpa mengambil kira pertindihan maklumat dengan pemboleh ubah tak bersandar yang lain (X3).Sebagai contoh, misalkan kita ingin mengkaji prestasi akademik pelajar (X2), dengan pemboleh ubah tak bersandar ialah tempoh masa belajar (X1) dan tahap IQ (X3). Di sini, kita ingin menilai sumbangan unik bagi faktor tempoh masa belajar terhadap prestasi akademik. Oleh itu, korelasi semi-separa akan membuang kesan tahap IQ hanya daripada pemboleh ubah tempoh masa belajar untuk membolehkan kita dapat melihat sumbangan unik yang didorong oleh faktor kerajinan pelajar berbanding kepintaran pelajar.

Nota: Imej ini dijana menggunakan Google Gemini
Matriks Korelasi dan Korelasi Kanonik
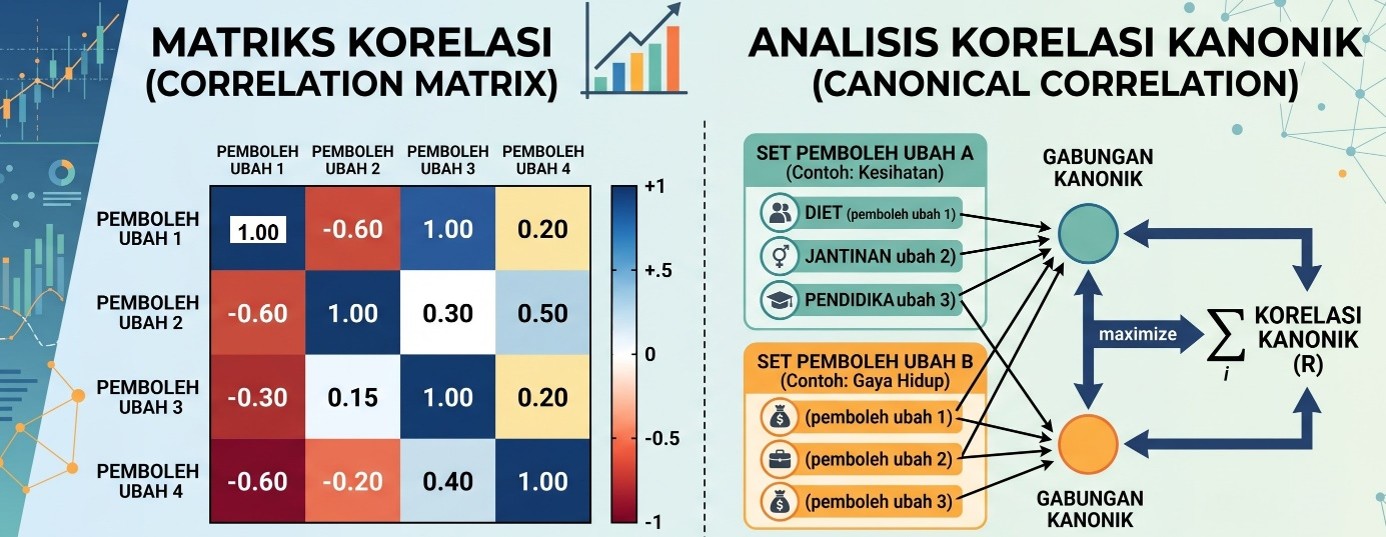
Kaedah korelasi ini digunakan apabila kita berurusan dengan data dengan bilangan pemboleh ubah yang banyak secara serentak. Matrik korelasi diterbitkan daripada ukuran korelasi berganda antara setiap kombinasi pasangan pemboleh ubah rawak yang terlibat. Ianya memaparkan hubungan korelasi yang menyeluruh terhadap set pemboleh ubah multivariat. Maklumat matrik korelasi ini sangat berguna dalam pelbagai kaedah statistik dan pembelajaran mesin. Manakala, kaedah korelasi kanonik pula mengukur hubungan antara suatu set pemboleh ubah dengan suatu set pemboleh ubah yang lain. Ianya menilai hubungan korelasi antara dua kumpulan pemboleh ubah yang berbeza dengan menggabungkannya kepada suatu set pemboleh ubah multivariat yang baharu dalam bentuk kombinasi linear yang dikenali sebagai pemboleh ubah kanonik. Seterusnya, korelasi antara pasangan pemboleh ubah ubah kanonik dikenali sebagai korelasi kanonik (Hardle & Simar, 2019).
Nota: Imej ini dijana menggunakan Google Gemini
Selain daripada teknik-teknik korelasi yang dibincangkan di atas, terdapat banyak lagi ukuran korelasi data yang boleh digunakan bersesuaian dengan sifat data yang khusus, antaranya ialah korelasi reruang (spatial correlation), korelasi membulat (circular correlation), korelasi rentas (cross correlation), korelasi penggulingan (rolling correlation), korelasi dinamik (dynamic correlation), korelasi Bayesan (Bayesian correlation), kopula (copula), dan banyak lagi. Oleh itu, pilihlah kaedah yang bersesuaian agar hasil analisis yang diperolehi adalah tepat untuk menggambarkan hubungan sebenar yang wujud dalam data. Sesuai dengan ungkapan, “tiada satu kunci yang boleh membuka semua pintu, setiap pintu memerlukan anak kuncinya yang tersendiri”.
Rujukan:
Chattamvelli, R. (2024). Correlation in Engineering and the Applied Sciences. Applications in R. Springer.
Drasgow, F. (1986). Polychoric and polyserial correlations. Pp. 68-74 in S. Kotz and N. Johnson, eds., The Encyclopedia of Statistics, Volume 7. Wiley.
Galton, F. (1988). Co-relations and their measurement, chiefly from anthropometric data. Proceedings of the Royal Society of London 45: 135–145.
Hardle, W. K., Simar, L. (2019). Applied Multivariate Statistical Analysis. Fifth Edition. Springer.
Kendall, M. G. (1948). Rank Correlation Methods. Griffen Publishing, London.
Pearson, K. (1896). Mathematical contributions to the theory of evolution. III. Regression, heredity, and panmixia. Philisopical Transactions of the Royal Society of London. Series A 187: 254–318
Wang J. (2013). Partial Correlation Coefficient. In: Dubitzky W., Wolkenhauer O., Cho KH., Yokota H. (eds) Encyclopedia of Systems Biology. Springer, New York, NY
Zar, J.H. (2005). Spearman rank correlation. Encyclopedia of Biostatistics. John Wiley & Sons.